Tout a commencé par un email
Un matin, nous avons reçu un email détaillé d'un joueur qui avait testé nos bots. Ses conclusions étaient édifiantes : les bots étiquetés comme joueurs de club jouaient en réalité au niveau Candidat Maître, bien au-delà de ce que leur palier de difficulté suggérait. Un bot du palier Apprenti ne devrait pas écraser des joueurs de club expérimentés. Sur des plateformes comme Chess.com, les joueurs utilisent les bots comme jalons personnels. Si nos niveaux de difficulté sont faux, les joueurs évaluent mal leur propre niveau, et les débutants se font écraser par des adversaires qu'ils pensaient accessibles. Nous avons décidé d'agir sur deux fronts : premièrement, recalibrer chaque bot pour que la progression de difficulté soit régulière et correctement ordonnée, et deuxièmement, retirer les classements Elo de l'interface de l'application. Afficher un nombre comme 1500 invite à la comparaison directe avec d'autres plateformes, mais les échelles de classement au Xiangqi varient énormément d'un site à l'autre. À la place, nous organisons les bots en paliers de difficulté clairs pour que les joueurs puissent se concentrer sur le bon niveau de défi sans se soucier d'un nombre qui pourrait ne pas signifier ce qu'ils croient.
Pourquoi Pikafish rend la calibration difficile
Xiangqi One utilise Pikafish, le moteur Xiangqi open-source le plus puissant, comme cerveau de chaque bot. Pikafish est incroyablement performant, mais cette puissance est une arme à double tranchant. Même avec des réglages de recherche très bas, Pikafish joue bien au-dessus du niveau débutant. Sa force croît de façon exponentielle avec la profondeur de recherche, pas linéairement. Passer de la profondeur 1 à la profondeur 3 ne triple pas la force, cela peut la multiplier par dix. On ne peut donc pas simplement faire correspondre la profondeur du moteur à une échelle Elo linéaire et s'en contenter. Chaque bot sur Xiangqi One n'est pas un simple moteur brut. C'est une personnalité construite à partir de plusieurs paramètres : profondeur de recherche, nombre de coups candidats à considérer (MultiPV), nombre d'erreurs intentionnelles du bot, variance du taux d'erreur, et si le bot choisit le meilleur candidat ou joue de manière plus aléatoire. Ajuster tous ces paramètres pour 22 bots différents, du débutant absolu au quasi-grand maître, est le cœur du défi de calibration.
Construire l'infrastructure de tournoi
Pour mesurer la force réelle des bots, nous avions besoin qu'ils jouent entre eux à grande échelle — pas des dizaines de parties, mais des dizaines de milliers. Nous avons construit un système de tournoi qui planifie les confrontations entre chaque paire de bots voisins, alterne les couleurs pour que chaque camp joue Rouge et Noir à égalité, et stocke chaque résultat dans une base de données. Chaque ronde de tournoi génère environ 400 parties par paire de bots, ce qui nous donne des résultats statistiquement significatifs. Après toutes les parties, nous exportons les résultats en fichiers PGN et les envoyons à Ordo, un système de classement Bradley-Terry qui calcule des classements Elo à partir des résultats de parties. Ordo est le même outil utilisé par la communauté des échecs informatiques pour évaluer les moteurs. Il produit un classement pour chaque bot avec des marges d'erreur, nous donnant une image précise de la force relative réelle.
Les premiers résultats : à quel point nous avions tort
Les premiers résultats du tournoi ont été un électrochoc. Nos profils initiaux, configurés avec des classements allant de 280 à 2500, étaient complètement décalibrés. Le graphique ci-dessous montre l'état initial : chaque point est un bot, l'axe X est le classement configuré dans notre code, et l'axe Y est l'Elo mesuré par le tournoi.
Note importante : l'Elo mesuré est relatif au groupe de bots (Ordo ancre la moyenne à 1000), donc les valeurs absolues n'ont pas besoin de correspondre aux classements configurés. Ce qui compte, c'est que les bots soient correctement ordonnés et régulièrement espacés.

Les résultats ont révélé de sérieux problèmes. Les bots du haut (Elena, Jun-so, Katya) étaient regroupés à une force quasi identique malgré des configurations séparées de centaines de points. Plusieurs bots étaient dans le mauvais ordre, des bots soi-disant plus faibles battant des bots soi-disant plus forts. Le graphique de progression rend ces problèmes encore plus visibles. Au lieu d'un escalier progressif de difficulté croissante, il y avait d'énormes groupes où plusieurs bots jouaient à force quasi identique, et de grands sauts où la difficulté augmentait brutalement.

Un joueur passant d'Erik (680) à Ông Minh (760) aurait à peine remarqué une différence, mais le saut de Dewi à Xinping était comme se heurter à un mur. Ce n'est pas l'expérience que nous voulions.
Le processus d'ajustement : quatre itérations de tournoi
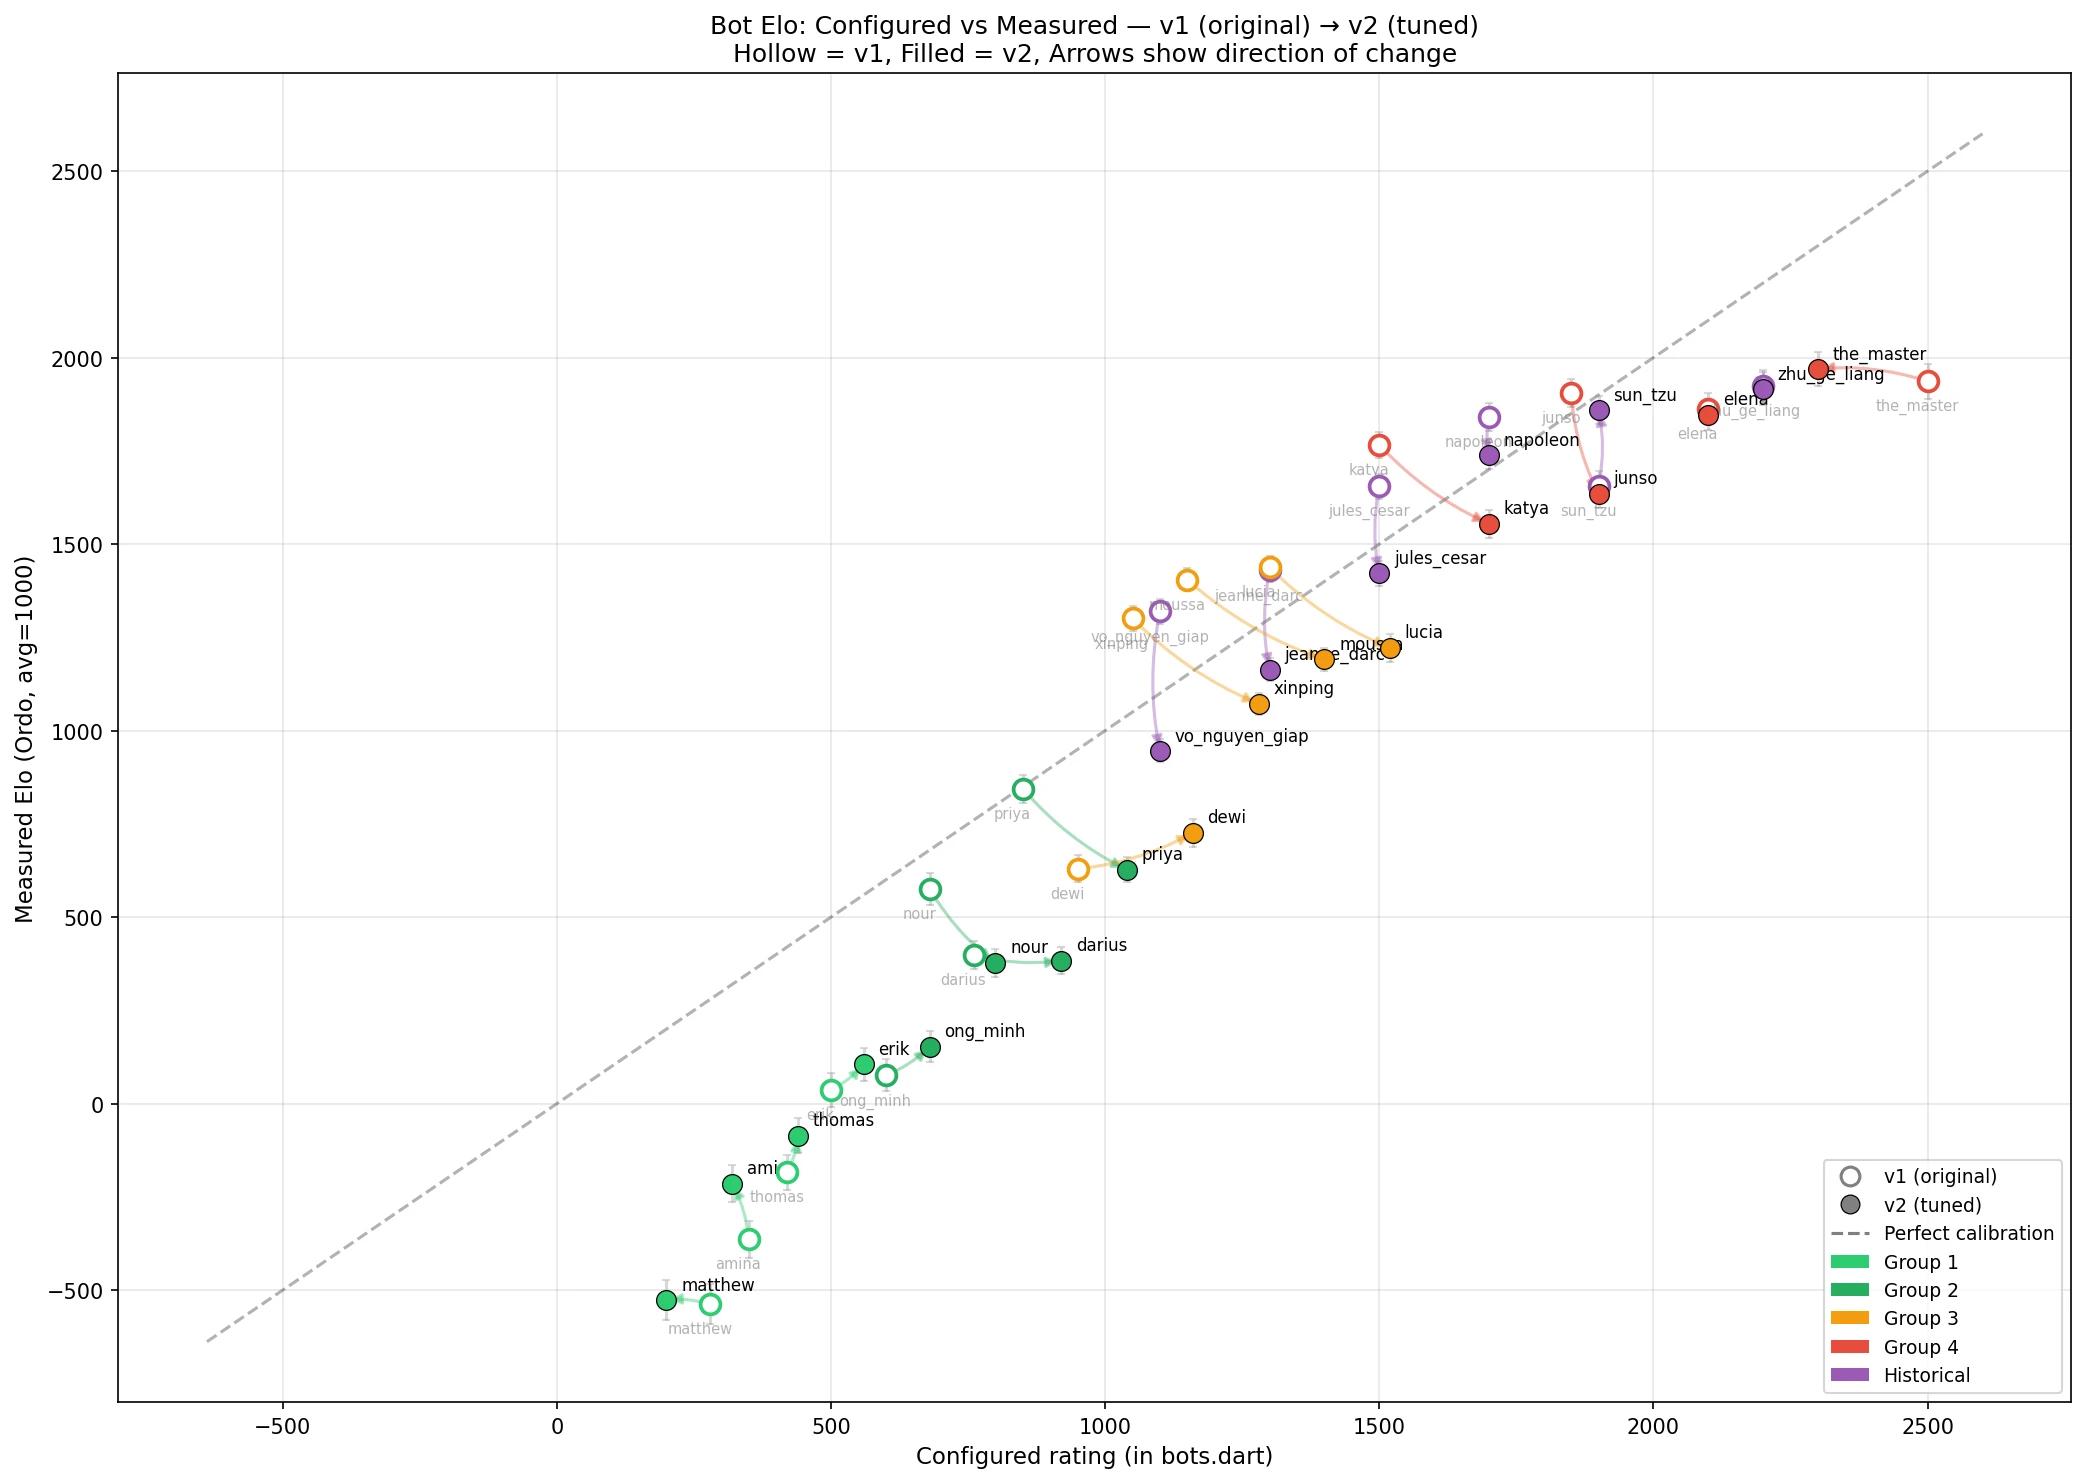
Corriger la calibration a nécessité plusieurs cycles d'ajustement. Après chaque tournoi, nous avons analysé les résultats, identifié les pires cas, ajusté les profils moteur, et relancé un tournoi. Lors du premier cycle, nous avons ajusté les classements configurés pour mieux correspondre à la force mesurée et identifié les bots nécessitant les plus gros changements de profil. Une découverte récurrente était que les bots au style défensif surperformaient systématiquement leurs profils. Un bot défensif mesurait des centaines de points Elo au-dessus d'un bot agressif configuré de manière similaire. Nous avons dû affaiblir significativement plusieurs bots défensifs, notamment Nour et Vo Nguyen Giap. Au quatrième tournoi, chaque bot respectait la hiérarchie prévue, avec un espacement raisonnablement régulier entre les niveaux de difficulté. Les plus gros changements individuels incluaient le renforcement de Sun Tzu de plus de 200 points Elo (en lui donnant une recherche plus profonde et un jeu plus précis), l'affaiblissement de Jun-so de 270 points (il était bien trop fort pour son palier), et la refonte complète des quatre bots les plus faibles pour créer une introduction plus douce pour les nouveaux joueurs. Ce sont ces paliers réajustés que vous rencontrez aujourd'hui quand vous jouez contre un bot.
Avant et après : mesurer l'amélioration
Pour valider que nos changements fonctionnaient réellement, nous avons organisé un tournoi de comparaison spécial : les 22 bots dans leur configuration originale (v1) ont joué contre les 22 bots dans leur configuration ajustée (v2) sur la même échelle Elo. Cela nous a donné une mesure directe et comparable de l'évolution de chaque bot.

Les flèches montrent la direction et l'amplitude du changement pour chaque bot. Les flèches bleues vers la droite signifient que le bot est devenu plus fort ; les flèches rouges vers la gauche signifient que nous l'avons affaibli avec succès. Les plus gros nerfs ont concerné les bots qui surperformaient dramatiquement : Vo Nguyen Giap a perdu 374 points Elo, Jun-so 270, et Jules Cesar 234. De l'autre côté, Sun Tzu a gagné 202 points pour prendre la place qui lui revient parmi les bots historiques les plus forts.
La vue combinée ci-dessous relie chaque bot entre les deux versions, montrant exactement comment la calibration a évolué.

Le graphique de calibration finale confirme qu'après les ajustements, les bots sont correctement ordonnés sans inversions, et l'espacement entre les niveaux de difficulté est beaucoup plus régulier.

La suite : transformer les parties en puzzles
Les dizaines de milliers de parties générées par notre système de tournoi ne servent pas qu'à la calibration. Chaque partie est une mine d'or de schémas tactiques et positionnels. Notre prochaine étape est d'exploiter ces parties pour créer des puzzles. Le système de tournoi stocke déjà les évaluations complètes position par position pour chaque partie. En cherchant les positions où l'évaluation bascule fortement — un joueur avait un coup gagnant mais l'adversaire l'a raté — nous pouvons extraire automatiquement des candidats puzzles. Cette approche nous fournit une source quasi illimitée de puzzles inédits et calibrés, tirés de parties aux positions réalistes, et non d'études de finales composées. Restez connectés pour notre prochain article. Si vous cherchez plutôt comment choisir un niveau et vous servir des bots pour progresser, notre guide pour jouer contre l'ordinateur traite le côté pratique.