Tudo começou com um e-mail
Certa manhã, recebemos um e-mail detalhado de um jogador que estava testando nossos bots. As descobertas dele foram surpreendentes: bots rotulados como jogadores de clube estavam, na verdade, jogando no nível de Candidato a Mestre, muito acima do que sua faixa de dificuldade sugeria. Um bot na faixa Aprendiz não deveria estar esmagando jogadores de clube experientes. Em plataformas como Chess.com, os jogadores usam bots como marcos pessoais. Se nossos níveis de dificuldade estão errados, os jogadores avaliam mal seu próprio nível, e iniciantes são massacrados por oponentes que acreditam estar ao seu alcance. Decidimos atacar o problema em duas frentes: primeiro, recalibrar cada bot para que a progressão de dificuldade seja suave e corretamente ordenada, e segundo, remover as classificações Elo da interface do aplicativo por completo. Mostrar um número como 1500 convida a comparações diretas com outras plataformas, mas as escalas de rating de Xiangqi variam enormemente entre sites. Em vez disso, organizamos os bots em faixas de dificuldade claras para que os jogadores possam se concentrar em encontrar o nível de desafio certo sem se preocupar com um número que pode não significar o que eles pensam.
Por que o Pikafish torna a calibração difícil
O Xiangqi One usa o Pikafish, o mais forte motor de Xiangqi de código aberto, como o cérebro por trás de cada bot. O Pikafish é incrivelmente poderoso, mas esse poder é uma faca de dois gumes. Mesmo com configurações de busca muito baixas, o Pikafish joga muito acima do nível iniciante. Sua força cresce exponencialmente com a profundidade de busca, não linearmente. Ir da profundidade 1 para a profundidade 3 não triplica a força — pode multiplicá-la por dez. Isso significa que não basta simplesmente mapear a profundidade do motor para uma escala Elo linear e dar o trabalho por encerrado. Cada bot no Xiangqi One não é apenas um motor bruto. É uma personalidade construída a partir de vários parâmetros: profundidade de busca, quantos lances candidatos considerar (MultiPV), quantos erros intencionais o bot comete, variância na taxa de erro e se o bot escolhe o melhor candidato ou opta de forma mais aleatória. Ajustar todos esses parâmetros corretamente para 22 bots diferentes, abrangendo do iniciante absoluto ao quase nível de grande mestre, é o cerne do desafio de calibração.
Construindo a infraestrutura de torneios
Para medir a força real dos bots, precisávamos que eles jogassem entre si em larga escala — não dezenas de partidas, mas dezenas de milhares. Construímos um sistema de torneios que agenda confrontos entre cada par de bots próximos, alterna as cores para que ambos os lados joguem igualmente de Vermelho e Preto, e armazena cada resultado de partida em um banco de dados. Cada rodada de torneio gera cerca de 400 partidas por par de bots, o que nos dá resultados estatisticamente significativos. Depois que todas as partidas são jogadas, exportamos os resultados como arquivos PGN e os alimentamos no Ordo, um sistema de classificação Bradley-Terry que calcula ratings Elo a partir dos resultados das partidas. O Ordo é a mesma ferramenta usada pela comunidade de xadrez computacional para avaliar motores. Ele fornece um rating para cada bot com margens de erro, nos dando uma imagem precisa da força relativa real.
Os primeiros resultados: o quanto estávamos errados
Os primeiros resultados do torneio foram um choque de realidade. Nossos perfis iniciais de bots, configurados com ratings variando de 280 a 2500, estavam completamente descalibrados. O gráfico abaixo mostra o estado inicial: cada ponto é um bot, o eixo X é o rating configurado no nosso código e o eixo Y é o Elo medido no torneio.
Nota importante: o Elo medido é relativo ao grupo de bots (o Ordo ancora a média em 1000), então os números absolutos não precisam corresponder aos ratings configurados. O que importa é que os bots estejam corretamente ordenados e uniformemente espaçados.

Os resultados revelaram problemas sérios. Os bots do topo (Elena, Jun-so, Katya) estavam agrupados com força praticamente idêntica, apesar de estarem configurados com centenas de pontos de diferença. Vários bots estavam completamente fora de ordem, com bots supostamente mais fracos vencendo os supostamente mais fortes. O gráfico de progressão torna esses problemas ainda mais visíveis. Em vez de uma escada suave de dificuldade crescente, havia aglomerados massivos onde vários bots jogavam com força praticamente idêntica e grandes lacunas onde a dificuldade saltava abruptamente.

Um jogador passando de Erik (680) para Ông Minh (760) mal notaria a diferença, mas saltar de Dewi para Xinping era como bater em uma parede. Essa não era a experiência que queríamos.
O processo de ajuste: quatro iterações de torneio
Corrigir a calibração exigiu múltiplas rodadas de ajuste. Após cada torneio, analisamos os resultados, identificamos os piores casos, ajustamos os perfis do motor e rodamos outro torneio. Na primeira rodada, ajustamos os ratings configurados para melhor corresponder à força medida e identificamos os bots que precisavam das maiores mudanças de perfil. Um padrão recorrente que descobrimos foi que bots com estilo defensivo consistentemente superavam seus perfis. Um bot com estilo de jogo defensivo media centenas de pontos Elo acima de um bot agressivo configurado de forma similar. Tivemos que enfraquecer significativamente vários bots defensivos, particularmente Nour e Vo Nguyen Giap. No quarto torneio, todos os bots respeitavam a hierarquia pretendida, com espaçamento razoavelmente uniforme entre os níveis de dificuldade. As maiores mudanças individuais incluíram aumentar Sun Tzu em mais de 200 pontos Elo (dando a ele uma busca mais profunda e jogo mais preciso), enfraquecer Jun-so em 270 pontos (ele era forte demais para sua faixa) e reformular completamente os quatro bots mais fracos para criar uma introdução mais suave para novos jogadores. Essa escada de dificuldade é a que você percorre hoje ao testar cada nível contra os bots de IA.
Antes e depois: medindo a melhoria
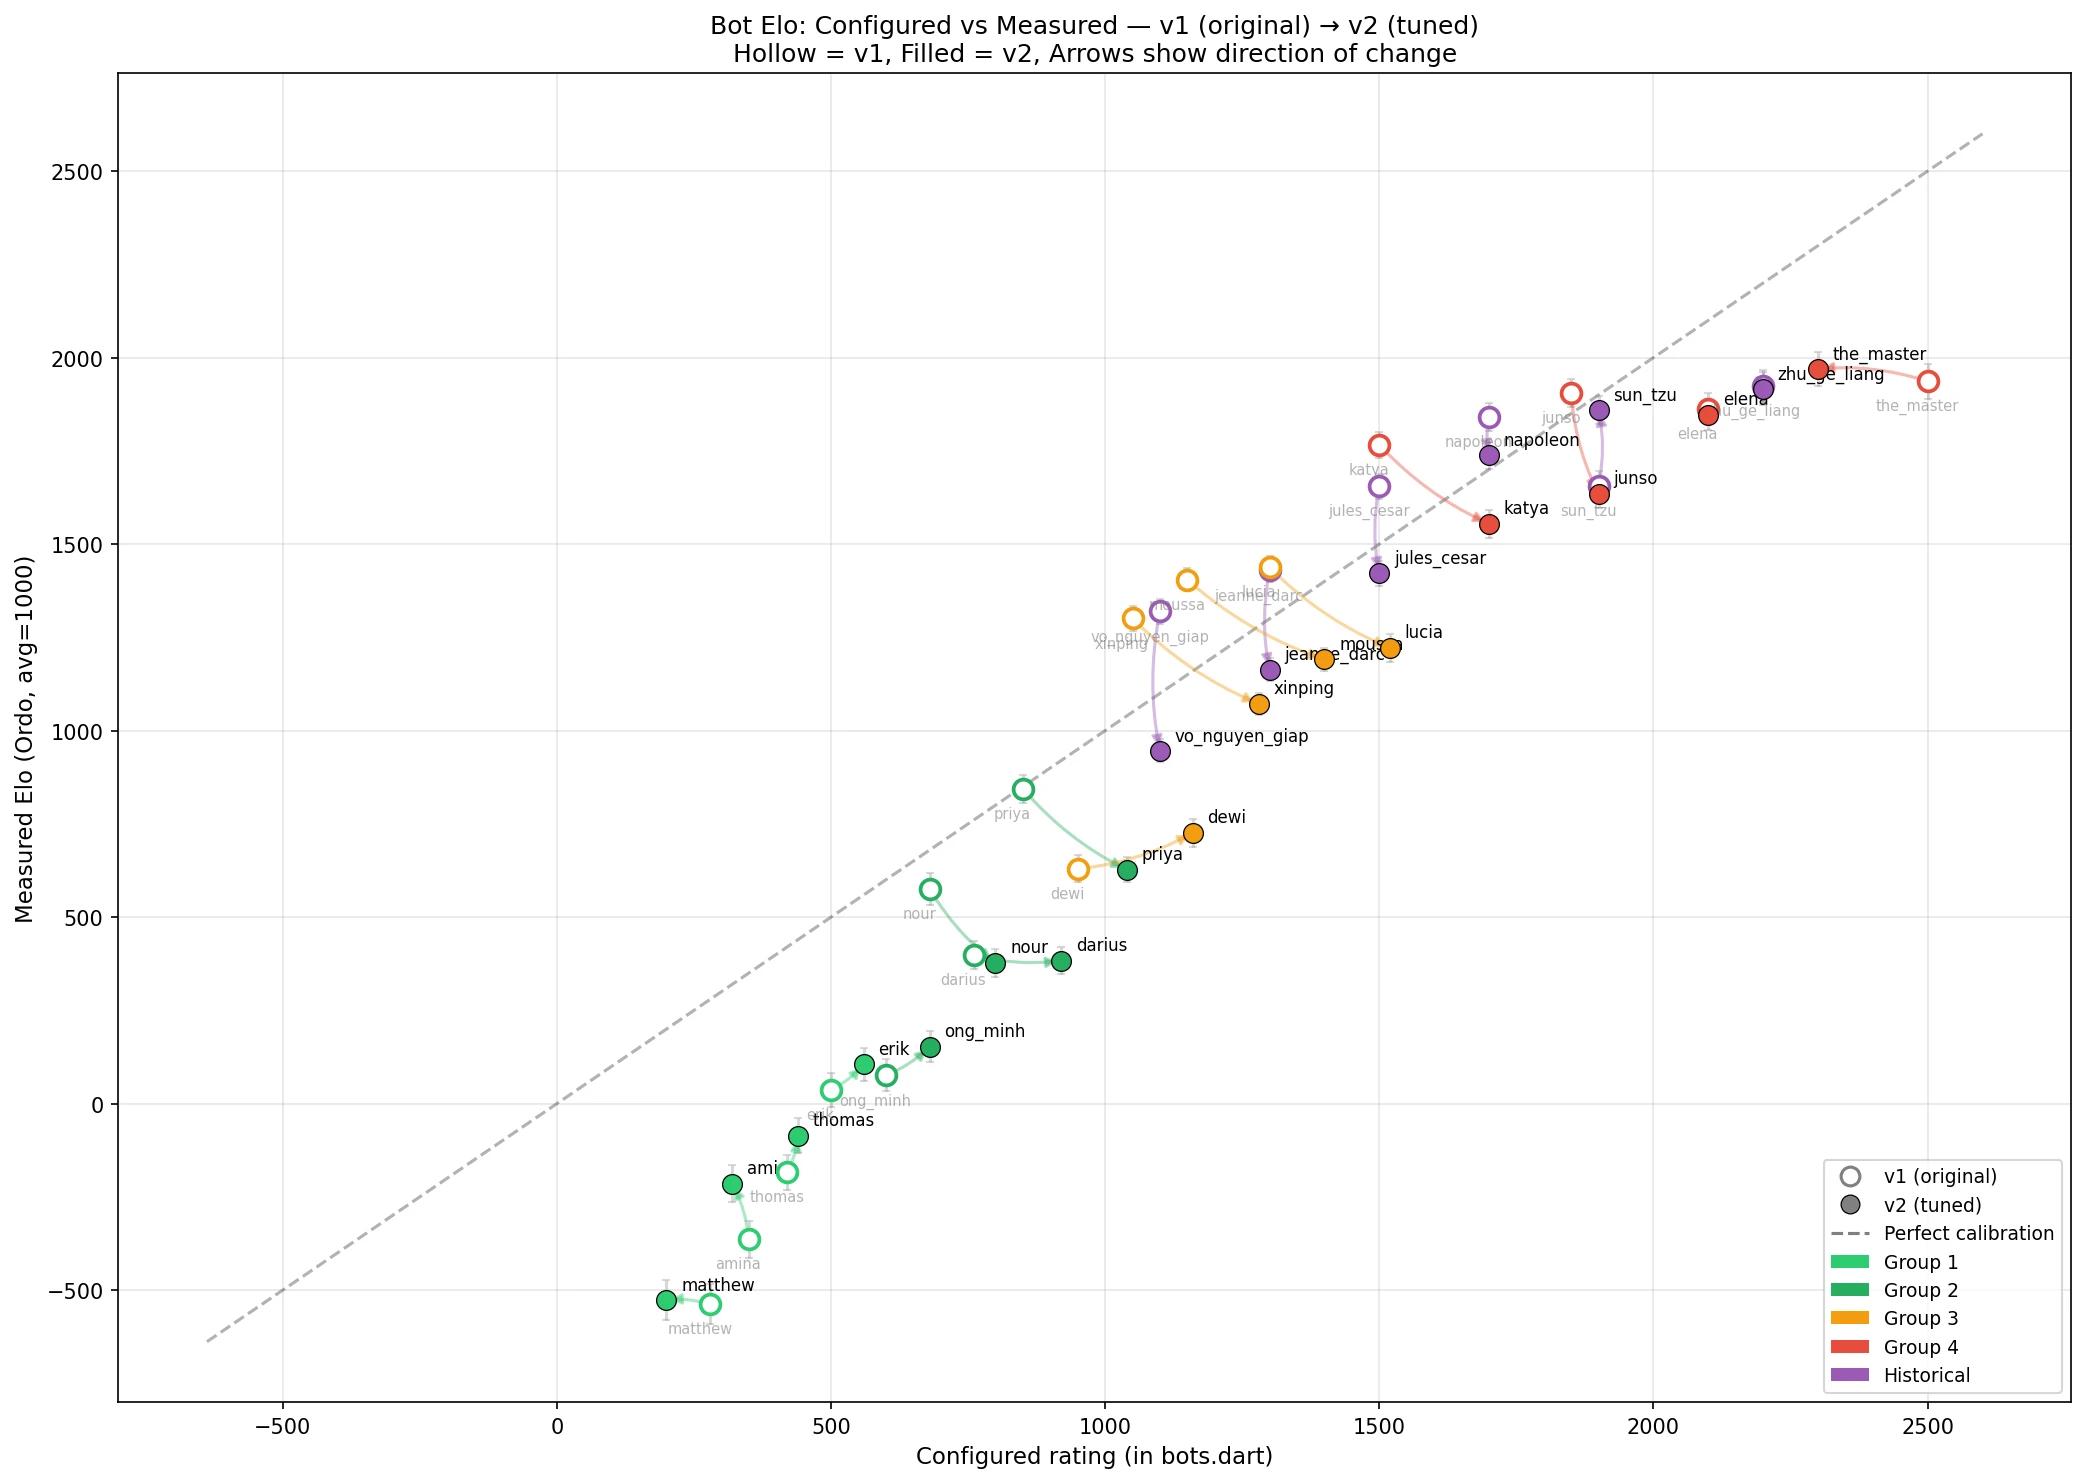
Para validar que nossas mudanças realmente funcionaram, rodamos um torneio especial de comparação: todos os 22 bots em sua configuração original (v1) jogaram contra todos os 22 bots em sua configuração ajustada (v2) na mesma escala Elo. Isso nos deu uma medição direta e equivalente de como cada bot mudou.

As setas mostram a direção e a magnitude da mudança para cada bot. Setas azuis apontando para a direita significam que o bot ficou mais forte; setas vermelhas apontando para a esquerda significam que conseguimos enfraquecê-lo. Os maiores enfraquecimentos foram para bots que estavam dramaticamente acima do esperado: Vo Nguyen Giap caiu 374 pontos Elo, Jun-so caiu 270 e Jules Cesar caiu 234. Do outro lado, Sun Tzu ganhou 202 pontos para assumir seu lugar de direito entre os bots históricos mais fortes.
A visão combinada abaixo conecta cada bot entre as duas versões, mostrando exatamente como a calibração mudou.

O gráfico final de calibração confirma que, após o ajuste, os bots estão corretamente ordenados sem inversões, e o espaçamento entre os níveis de dificuldade é muito mais uniforme.

O que vem a seguir: transformando partidas em puzzles
As dezenas de milhares de partidas geradas pelo nosso sistema de torneios não são úteis apenas para calibração. Cada partida é uma mina de ouro de padrões táticos e posicionais. Nosso próximo passo é explorar essas partidas em busca de material para puzzles. O sistema de torneios já armazena avaliações completas do motor posição por posição para cada partida. Ao procurar posições onde a avaliação oscila bruscamente — um jogador tinha um lance vencedor, mas o oponente não o encontrou — podemos extrair automaticamente candidatos a puzzles. Essa abordagem nos dá um suprimento quase ilimitado de puzzles novos e classificados, extraídos de partidas com posições realistas, não estudos de finais compostos. Fique atento ao nosso próximo artigo. Se o que procura é como escolher um nível e usar os bots para evoluir, o nosso guia para jogar contra o computador trata do lado prático.