一切始于一封邮件
一天早上,我们收到了一封来自一位棋手的详细邮件,他一直在测试我们的机器人。他的发现令人大开眼界:标注为俱乐部棋手水平的机器人,实际上在以候选大师的水平下棋,远远超出其难度等级所暗示的强度。一个处于学徒等级的机器人不应该轻松碾压经验丰富的俱乐部棋手。在 Chess.com 等平台上,棋手将机器人作为衡量自身水平的里程碑。如果我们的难度等级标注有误,棋手就会错误判断自己的水平,而初学者则会被他们认为应该能够对抗的对手击溃。我们决定从两个方面解决这个问题:第一,重新校准每个机器人,使难度递进平滑且排序正确;第二,从应用界面中完全移除 Elo 等级分。展示像1500这样的数字会引发与其他平台的直接对比,但象棋评分体系在不同网站之间差异极大。因此,我们将机器人组织成清晰的难度梯队,让棋手专注于寻找合适的挑战级别,而不必担心一个可能与他们预期含义不同的数字。今天你在象棋AI机器人页面上看到的分级,就是这次重新校准之后的结果。
为什么 Pikafish 让校准变得困难
Xiangqi One 使用 Pikafish——最强的开源象棋引擎——作为每个机器人的大脑。Pikafish 异常强大,但这种强大是一把双刃剑。即使在非常低的搜索设置下,Pikafish 的棋力也远超初学者水平。它的强度随搜索深度呈指数增长,而非线性增长。从深度1到深度3,强度不是提升三倍,而可能提升十倍。这意味着你不能简单地将引擎深度映射到一个线性的 Elo 等级表上就万事大吉了。Xiangqi One 上的每个机器人不仅仅是一个原始引擎,它是由多个参数构建的个性化角色:搜索深度、考虑多少候选着法(MultiPV)、机器人故意犯多少错误、失误率的波动范围,以及机器人是选择最佳候选着法还是更随机地选择。要为22个不同的机器人——跨度从纯粹的初学者到接近特级大师水平——调好所有这些参数,这就是校准挑战的核心所在。
搭建锦标赛基础设施
为了测量机器人的真实棋力,我们需要让机器人大规模地互相对弈——不是几十局,而是数万局。我们搭建了一个锦标赛系统,它会为每对相邻机器人安排对局,交替先后手以确保双方平等地执红和执黑,并将每局结果存入数据库。每轮锦标赛为每对机器人生成约400局对弈,这为我们提供了具有统计意义的结果。所有对局结束后,我们将结果导出为 PGN 文件,然后输入 Ordo——一个基于 Bradley-Terry 模型的等级分系统,能够从对局结果计算 Elo 等级分。Ordo 是电脑棋类社区用来评估引擎的同款工具。它会为每个机器人输出带误差范围的等级分,为我们提供真实相对强度的精确画面。
初始结果:我们偏差了多少
第一次锦标赛的结果给了我们一记警钟。我们最初的机器人配置,设定的等级分范围从280到2500,严重偏离了实际水平。下面的图表展示了初始状态:每个点代表一个机器人,X轴是我们代码中配置的等级分,Y轴是锦标赛测量出的 Elo 等级分。
重要说明:测量的 Elo 是相对于机器人池的(Ordo 将平均值锚定在1000),因此绝对数值不需要与配置的等级分相匹配。关键在于机器人的排序正确且间距均匀。

结果暴露了严重问题。排名最高的机器人(Elena、Jun-so、Katya)实际棋力几乎相同,尽管配置的等级分相差数百分。好几个机器人的排序完全颠倒,理应较弱的机器人反而击败了理应更强的。递进图表让这些问题更加直观。原本应该呈现平滑阶梯式的难度递增,却出现了大量机器人棋力几乎相同的扎堆现象,以及难度骤然跳升的大幅断层。

一个棋手从 Erik(680)升级到 Ông Minh(760)几乎感受不到差异,但从 Dewi 跳到 Xinping 却像撞上了一堵墙。这不是我们想要的体验。
调优过程:四轮锦标赛迭代
修正校准需要多轮调整。每次锦标赛结束后,我们分析结果,找出偏差最严重的机器人,调整引擎配置,然后再运行一次锦标赛。在第一轮中,我们调整了配置的等级分以更好地匹配实测强度,并找出了需要最大幅度修改配置的机器人。我们发现了一个反复出现的规律:防守型风格的机器人始终表现出超越其配置的实力。一个防守型机器人的实测 Elo 会比配置相似的进攻型机器人高出数百分。我们不得不大幅削弱几个防守型机器人,特别是 Nour 和 Vo Nguyen Giap。到第四轮锦标赛时,每个机器人都遵守了预设的层级关系,各难度等级之间的间距也相当均匀。最大的单项调整包括:将 Sun Tzu 提升了超过200 Elo 分(赋予他更深的搜索和更精准的下法),将 Jun-so 削弱了270分(他对于其所在梯队来说太强了),以及彻底重做了最弱的四个机器人,为新手玩家创造更温和的入门体验。
调整前后:量化改进效果
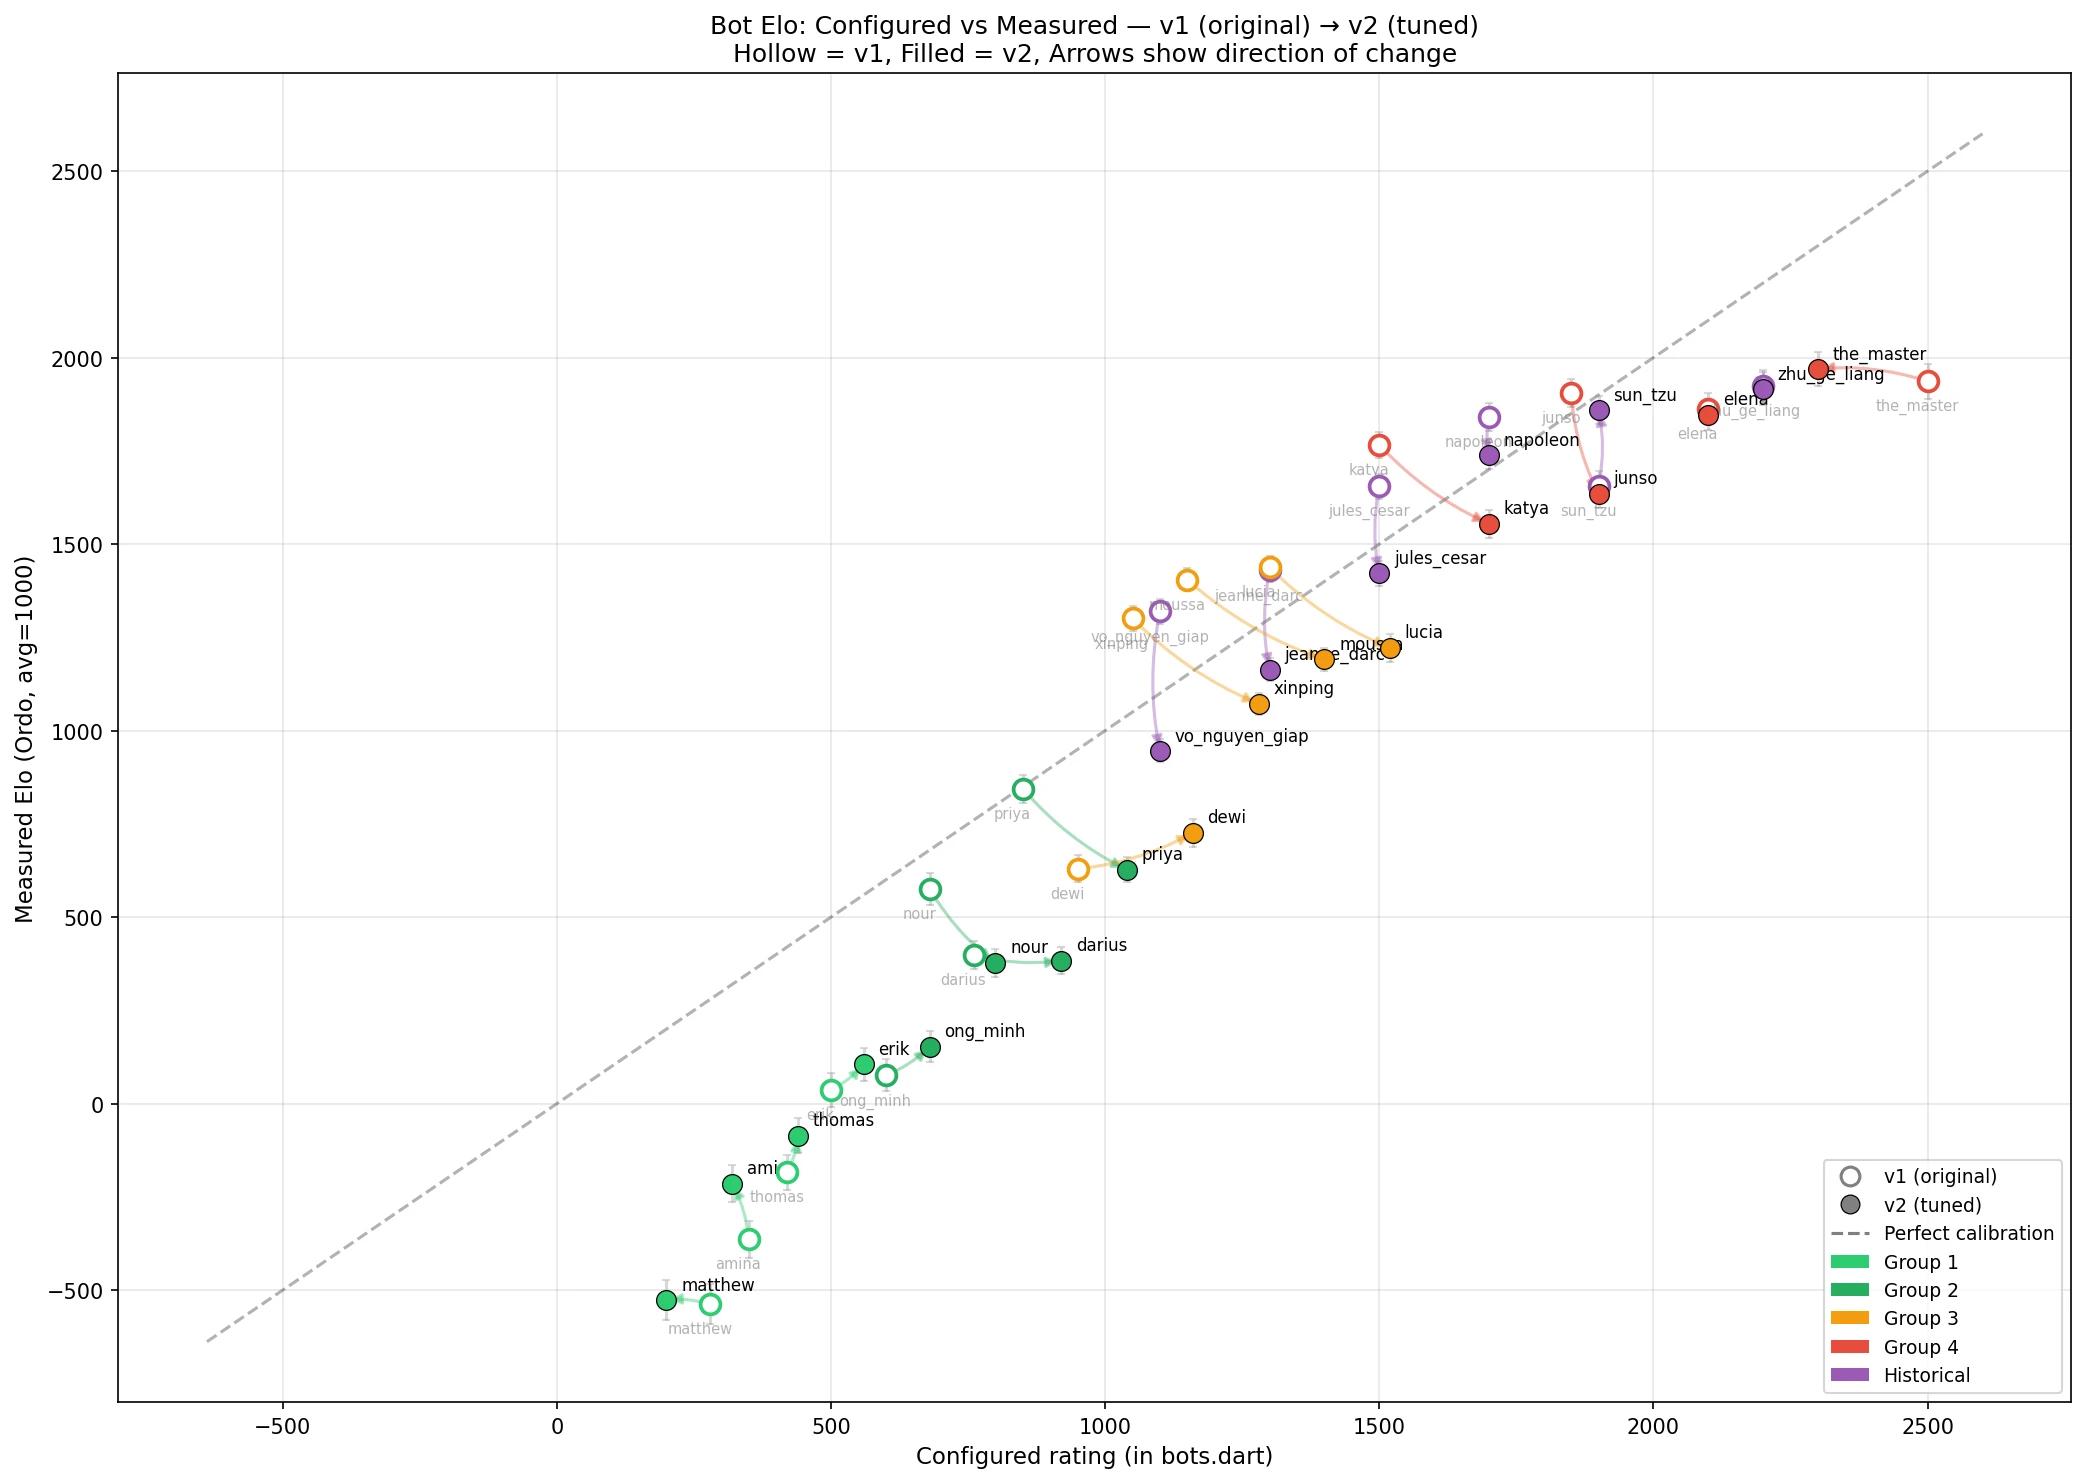
为了验证我们的改动确实有效,我们运行了一场特殊的对比锦标赛:全部22个原始配置(v1)的机器人与全部22个调优后配置(v2)的机器人在同一 Elo 标尺下对弈。这为我们提供了每个机器人变化的直接、同等条件下的测量。

箭头显示了每个机器人变化的方向和幅度。蓝色向右的箭头表示机器人变强了;红色向左的箭头表示我们成功地削弱了它。被削弱幅度最大的是那些严重超越预期表现的机器人:Vo Nguyen Giap 下降了374 Elo 分,Jun-so 下降了270分,Jules Cesar 下降了234分。另一方面,Sun Tzu 提升了202分,占据了他在最强历史人物机器人中应有的位置。
下面的综合视图将每个机器人在两个版本中的表现关联起来,准确展示了校准是如何变化的。

最终校准图表确认,经过调优后,机器人排序正确,没有逆序现象,各难度等级之间的间距也更加均匀。

下一步:将对局转化为谜题
我们的锦标赛系统生成的数万局对弈不仅仅对校准有用,每一局都是战术和布局模式的宝库。我们的下一步是从这些对局中挖掘谜题素材。锦标赛运行器已经为每局对弈存储了逐个局面的完整引擎评估。通过寻找评估值急剧变化的局面——一方有一步制胜着法但对手漏掉了——我们可以自动提取候选谜题。这种方法为我们提供了近乎无限的新鲜的、有难度评级的谜题,它们来源于具有真实局面的对弈,而非人工编排的残局研究。请期待我们的下一篇文章。如果你更想知道怎么选难度、怎么用机器对手提高棋力,我们的和电脑下象棋指南讲的是实操那一面。