Todo empezó con un correo electrónico
Una mañana recibimos un correo electrónico detallado de un jugador que había estado probando nuestros bots. Sus hallazgos fueron reveladores: bots etiquetados como jugadores de club estaban en realidad jugando a nivel de Candidato a Maestro, muy por encima de lo que su nivel de dificultad sugería. Un bot en el nivel de Aprendiz no debería aplastar a jugadores de club experimentados. En plataformas como Chess.com, los jugadores usan los bots como objetivos personales. Si nuestros niveles de dificultad son incorrectos, los jugadores juzgan mal su propio nivel, y los principiantes son aplastados por oponentes que creen que deberían estar a su alcance. Decidimos abordar esto en dos frentes: primero, recalibrar cada bot para que la progresión de dificultad sea suave y correctamente ordenada, y segundo, eliminar las clasificaciones Elo de la interfaz de la aplicación por completo. Mostrar un número como 1500 invita a comparaciones directas con otras plataformas, pero las escalas de clasificación de Xiangqi varían enormemente entre sitios. En su lugar, organizamos los bots en niveles de dificultad claros para que los jugadores puedan concentrarse en encontrar el desafío adecuado sin preocuparse por un número que podría no significar lo que creen que significa.
Por qué Pikafish dificulta la calibración
Xiangqi One utiliza Pikafish, el motor de Xiangqi de código abierto más fuerte, como el cerebro detrás de cada bot. Pikafish es increíblemente potente, pero esa potencia es un arma de doble filo. Incluso con ajustes de búsqueda muy bajos, Pikafish juega muy por encima del nivel de principiante. Su fuerza crece exponencialmente con la profundidad de búsqueda, no linealmente. Pasar de profundidad 1 a profundidad 3 no triplica la fuerza, puede multiplicarla por diez. Esto significa que no puedes simplemente asignar la profundidad del motor a una escala Elo lineal y dar el trabajo por terminado. Cada bot en Xiangqi One no es solo un motor en bruto. Es una personalidad construida a partir de varios parámetros: profundidad de búsqueda, cuántos movimientos candidatos considerar (MultiPV), cuántos errores intencionales comete el bot, la varianza en la tasa de errores y si el bot elige el mejor candidato o selecciona de forma más aleatoria. Ajustar todos estos parámetros correctamente para 22 bots diferentes, que abarcan desde principiante absoluto hasta nivel casi de gran maestro, es el núcleo del desafío de calibración.
Construyendo la infraestructura del torneo
Para medir la fuerza real de los bots, necesitábamos que los bots jugaran entre sí a gran escala, no docenas de partidas, sino decenas de miles. Construimos un sistema de torneos que programa enfrentamientos entre cada par de bots cercanos, alterna los colores para que ambos bandos jueguen con Rojas y Negras por igual, y almacena cada resultado en una base de datos. Cada ronda del torneo genera alrededor de 400 partidas por par de bots, lo que nos proporciona resultados estadísticamente significativos. Una vez jugadas todas las partidas, exportamos los resultados como archivos PGN y los introducimos en Ordo, un sistema de clasificación Bradley-Terry que calcula clasificaciones Elo a partir de los resultados de las partidas. Ordo es la misma herramienta utilizada por la comunidad de ajedrez computacional para evaluar motores. Genera una clasificación para cada bot con márgenes de error, proporcionándonos una imagen precisa de la fuerza relativa real.
Los primeros resultados: cuán lejos estábamos
Los primeros resultados del torneo fueron una llamada de atención. Nuestros perfiles iniciales de bots, configurados con clasificaciones que iban de 280 a 2500, estaban enormemente descalibrados. El gráfico a continuación muestra el estado inicial: cada punto es un bot, el eje X es la clasificación configurada en nuestro código y el eje Y es el Elo medido en el torneo.
Nota importante: el Elo medido es relativo al grupo de bots (Ordo ancla el promedio en 1000), por lo que los números absolutos no necesitan coincidir con las clasificaciones configuradas. Lo que importa es que los bots estén correctamente ordenados y uniformemente espaciados.

Los resultados revelaron problemas serios. Los bots más fuertes (Elena, Jun-so, Katya) estaban agrupados con una fuerza casi idéntica a pesar de estar configurados con cientos de puntos de diferencia. Varios bots estaban completamente desordenados, con bots supuestamente más débiles venciendo a bots supuestamente más fuertes. El gráfico de progresión hace estos problemas aún más visibles. En lugar de una escalera suave de dificultad creciente, había grandes agrupaciones donde varios bots jugaban con una fuerza casi idéntica, y grandes brechas donde la dificultad saltaba abruptamente.

Un jugador que pasara de Erik (680) a Ong Minh (760) apenas notaría la diferencia, pero saltar de Dewi a Xinping era como chocar contra un muro. Esta no era la experiencia que queríamos.
El proceso de ajuste: cuatro iteraciones de torneo
Corregir la calibración requirió múltiples rondas de ajustes. Después de cada torneo, analizamos los resultados, identificamos los peores casos, modificamos los perfiles del motor y ejecutamos otro torneo. En la primera ronda, ajustamos las clasificaciones configuradas para que coincidieran mejor con la fuerza medida e identificamos los bots que necesitaban los mayores cambios de perfil. Un patrón recurrente que descubrimos fue que los bots con estilo defensivo superaban consistentemente sus perfiles. Un bot con un estilo de juego defensivo medía cientos de puntos Elo por encima de un bot agresivo configurado de manera similar. Tuvimos que debilitar significativamente varios bots defensivos, particularmente Nour y Vo Nguyen Giap. Para el cuarto torneo, todos los bots respetaban la jerarquía prevista, con un espaciado razonablemente uniforme entre los niveles de dificultad. Los mayores cambios individuales incluyeron aumentar a Sun Tzu en más de 200 puntos Elo (dándole una búsqueda más profunda y un juego más preciso), debilitar a Jun-so en 270 puntos (era demasiado fuerte para su nivel) y rehacer completamente los cuatro bots inferiores para crear una introducción más suave para los nuevos jugadores. Esa escalera de dificultad es la que recorres hoy al probar cada nivel contra los bots de IA.
Antes y después: midiendo la mejora
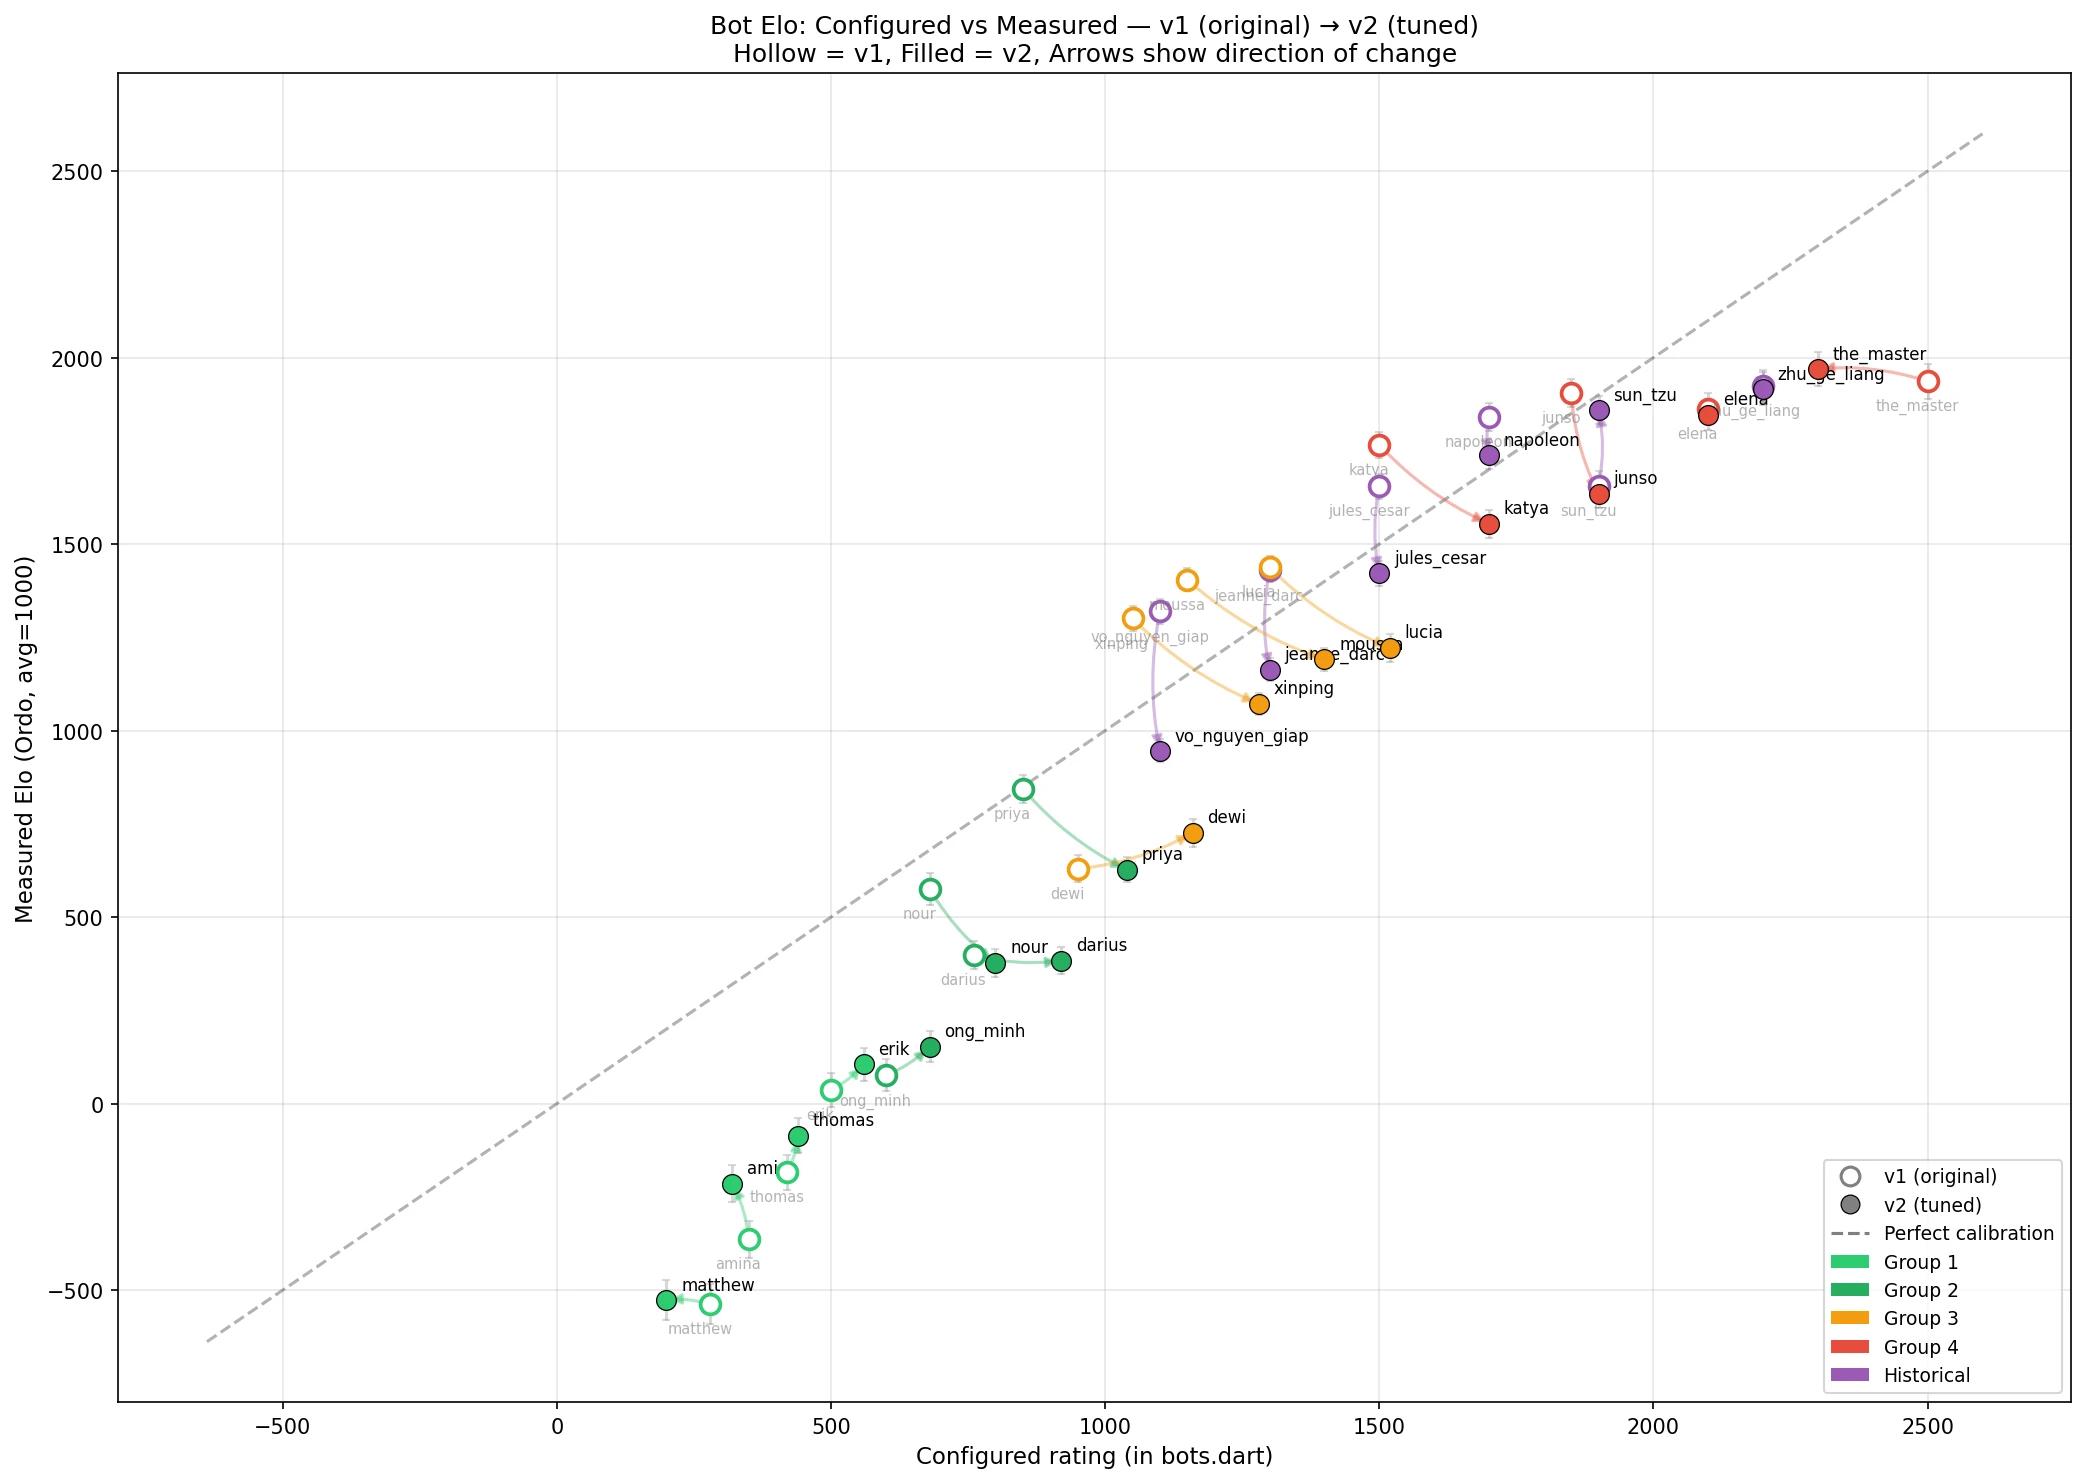
Para validar que nuestros cambios realmente funcionaron, ejecutamos un torneo de comparación especial: los 22 bots en su configuración original (v1) jugaron contra los 22 bots en su configuración ajustada (v2) en la misma escala Elo. Esto nos dio una medición directa y comparable de cómo cambió cada bot.

Las flechas muestran la dirección y la magnitud del cambio para cada bot. Las flechas azules que apuntan a la derecha significan que el bot se hizo más fuerte; las flechas rojas que apuntan a la izquierda significan que logramos debilitarlo. Los mayores debilitamientos fueron para los bots que estaban dramáticamente por encima de su nivel: Vo Nguyen Giap bajó 374 puntos Elo, Jun-so bajó 270 y Jules Cesar bajó 234. Por otro lado, Sun Tzu ganó 202 puntos para ocupar su lugar legítimo entre los bots históricos más fuertes.
La vista combinada a continuación vincula cada bot en ambas versiones, mostrando exactamente cómo cambió la calibración.

El gráfico de calibración final confirma que, después del ajuste, los bots están correctamente ordenados sin inversiones, y el espaciado entre niveles de dificultad es mucho más uniforme.

Lo que viene: convertir partidas en puzzles
Las decenas de miles de partidas generadas por nuestro sistema de torneos no solo son útiles para la calibración. Cada partida es una mina de oro de patrones tácticos y posicionales. Nuestro siguiente paso es extraer de estas partidas material para puzzles. El sistema de torneos ya almacena evaluaciones completas del motor posición por posición para cada partida. Al buscar posiciones donde la evaluación cambia bruscamente, un jugador tenía un movimiento ganador pero el oponente lo pasó por alto, podemos extraer automáticamente candidatos a puzzles. Este enfoque nos proporciona un suministro casi ilimitado de puzzles frescos y clasificados, extraídos de partidas con posiciones realistas, no estudios de finales compuestos. Permanezcan atentos a nuestro próximo artículo. Si lo que buscas es cómo elegir un nivel y usar los bots para mejorar, nuestra guía para jugar contra la computadora cubre la parte práctica.