Es begann mit einer E-Mail
Eines Morgens erhielten wir eine ausführliche E-Mail von einem Spieler, der unsere Bots getestet hatte. Seine Ergebnisse waren augenöffnend: Bots, die als Vereinsspieler eingestuft waren, spielten tatsächlich auf Kandidatenmeister-Niveau, weit über dem, was ihre Schwierigkeitsstufe vermuten ließ. Ein Bot in der Anfänger-Stufe sollte keine erfahrenen Vereinsspieler vernichten. Auf Plattformen wie Chess.com nutzen Spieler Bots als persönliche Meilensteine. Wenn unsere Schwierigkeitsgrade falsch sind, schätzen Spieler ihr eigenes Niveau falsch ein, und Anfänger werden von Gegnern geschlagen, die sie für erreichbar halten. Wir beschlossen, das Problem auf zwei Ebenen anzugehen: erstens, jeden Bot neu zu kalibrieren, damit die Schwierigkeitsprogression gleichmäßig und korrekt geordnet ist, und zweitens, Elo-Wertungen vollständig aus der App-Oberfläche zu entfernen. Eine Zahl wie 1500 anzuzeigen lädt zum direkten Vergleich mit anderen Plattformen ein, doch Xiangqi-Wertungsskalen variieren enorm zwischen verschiedenen Seiten. Stattdessen organisieren wir Bots in klare Schwierigkeitsstufen, damit sich Spieler darauf konzentrieren können, das richtige Herausforderungsniveau zu finden, ohne sich um eine Zahl zu sorgen, die vielleicht nicht das bedeutet, was sie denken.
Warum Pikafish die Kalibrierung erschwert
Xiangqi One verwendet Pikafish, die stärkste Open-Source-Xiangqi-Engine, als Gehirn hinter jedem Bot. Pikafish ist unglaublich leistungsstark, doch diese Stärke ist ein zweischneidiges Schwert. Selbst bei sehr niedrigen Sucheinstellungen spielt Pikafish weit über Anfängerniveau. Die Spielstärke wächst exponentiell mit der Suchtiefe, nicht linear. Von Tiefe 1 auf Tiefe 3 zu gehen verdreifacht die Stärke nicht, es kann sie verzehnfachen. Das bedeutet, dass man die Engine-Tiefe nicht einfach auf eine lineare Elo-Skala abbilden und es dabei belassen kann. Jeder Bot auf Xiangqi One ist nicht nur eine rohe Engine. Er ist eine Persönlichkeit, die aus mehreren Parametern aufgebaut ist: Suchtiefe, wie viele Kandidatenzüge berücksichtigt werden (MultiPV), wie viele absichtliche Fehler der Bot macht, Varianz in der Fehlerrate und ob der Bot den besten Kandidaten wählt oder zufälliger spielt. All diese Stellschrauben für 22 verschiedene Bots richtig einzustellen, die vom absoluten Anfänger bis zum Beinahe-Großmeister-Niveau reichen, ist der Kern der Kalibrierungsherausforderung.
Aufbau der Turnier-Infrastruktur
Um die tatsächliche Bot-Stärke zu messen, mussten die Bots im großen Maßstab gegeneinander spielen — nicht Dutzende Partien, sondern Zehntausende. Wir bauten ein Turniersystem, das Paarungen zwischen jedem Paar benachbarter Bots plant, die Farben abwechselt, damit beide Seiten gleich oft Rot und Schwarz spielen, und jedes Spielergebnis in einer Datenbank speichert. Jede Turnierrunde erzeugt etwa 400 Partien pro Bot-Paar, was uns statistisch aussagekräftige Ergebnisse liefert. Nachdem alle Partien gespielt sind, exportieren wir die Ergebnisse als PGN-Dateien und speisen sie in Ordo ein, ein Bradley-Terry-Wertungssystem, das Elo-Wertungen aus Partieergebnissen berechnet. Ordo ist dasselbe Werkzeug, das die Computerschach-Community zum Benchmarking von Engines verwendet. Es gibt für jeden Bot eine Wertung mit Fehlermargen aus und liefert uns ein präzises Bild der tatsächlichen relativen Stärke.
Die ersten Ergebnisse: Wie weit wir daneben lagen
Die ersten Turnierergebnisse waren ein Weckruf. Unsere anfänglichen Bot-Profile, konfiguriert mit Wertungen von 280 bis 2500, waren völlig falsch kalibriert. Das Diagramm unten zeigt den Ausgangszustand: Jeder Punkt ist ein Bot, die X-Achse ist die konfigurierte Wertung in unserem Code, und die Y-Achse ist der vom Turnier gemessene Elo-Wert.
Wichtiger Hinweis: Der gemessene Elo-Wert ist relativ zum Bot-Pool (Ordo verankert den Durchschnitt bei 1000), daher müssen die absoluten Zahlen nicht mit den konfigurierten Wertungen übereinstimmen. Entscheidend ist, dass die Bots korrekt geordnet und gleichmäßig verteilt sind.

Die Ergebnisse offenbarten schwerwiegende Probleme. Die Top-Bots (Elena, Jun-so, Katya) waren auf nahezu identischer Spielstärke gebündelt, obwohl sie hunderte Punkte auseinander konfiguriert waren. Mehrere Bots waren komplett in der falschen Reihenfolge, wobei vermeintlich schwächere Bots vermeintlich stärkere schlugen. Das Progressionsdiagramm macht diese Probleme noch sichtbarer. Statt einer gleichmäßigen Treppe zunehmender Schwierigkeit gab es massive Klumpen, in denen mehrere Bots auf nahezu identischer Stärke spielten, und große Lücken, in denen die Schwierigkeit abrupt anstieg.

Ein Spieler, der von Erik (680) zu Ông Minh (760) wechselte, hätte kaum einen Unterschied bemerkt, aber der Sprung von Dewi zu Xinping war wie gegen eine Wand zu laufen. Das war nicht die Erfahrung, die wir wollten.
Der Abstimmungsprozess: Vier Turnier-Iterationen
Die Korrektur der Kalibrierung erforderte mehrere Anpassungsrunden. Nach jedem Turnier analysierten wir die Ergebnisse, identifizierten die größten Ausreißer, passten die Engine-Profile an und starteten ein weiteres Turnier. In der ersten Runde glichen wir die konfigurierten Wertungen besser an die gemessene Stärke an und identifizierten die Bots, die die größten Profiländerungen brauchten. Ein wiederkehrendes Muster, das wir entdeckten, war, dass defensiv ausgerichtete Bots konstant über ihren Profilen spielten. Ein Bot mit defensivem Spielstil maß hunderte Elo-Punkte über einem ähnlich konfigurierten aggressiven Bot. Wir mussten mehrere defensive Bots deutlich abschwächen, insbesondere Nour und Vo Nguyen Giap. Beim vierten Turnier respektierte jeder Bot die vorgesehene Hierarchie mit einigermaßen gleichmäßigem Abstand zwischen den Schwierigkeitsstufen. Die größten individuellen Änderungen umfassten die Verstärkung von Sun Tzu um über 200 Elo-Punkte (mit tieferer Suche und präziserem Spiel), die Abschwächung von Jun-so um 270 Punkte (er war viel zu stark für seine Stufe) und die komplette Überarbeitung der vier schwächsten Bots, um neuen Spielern einen sanfteren Einstieg zu bieten. Genau diese neu abgestimmten Stufen triffst du heute an, wenn du gegen einen Bot spielst.
Vorher und nachher: Die Verbesserung messen
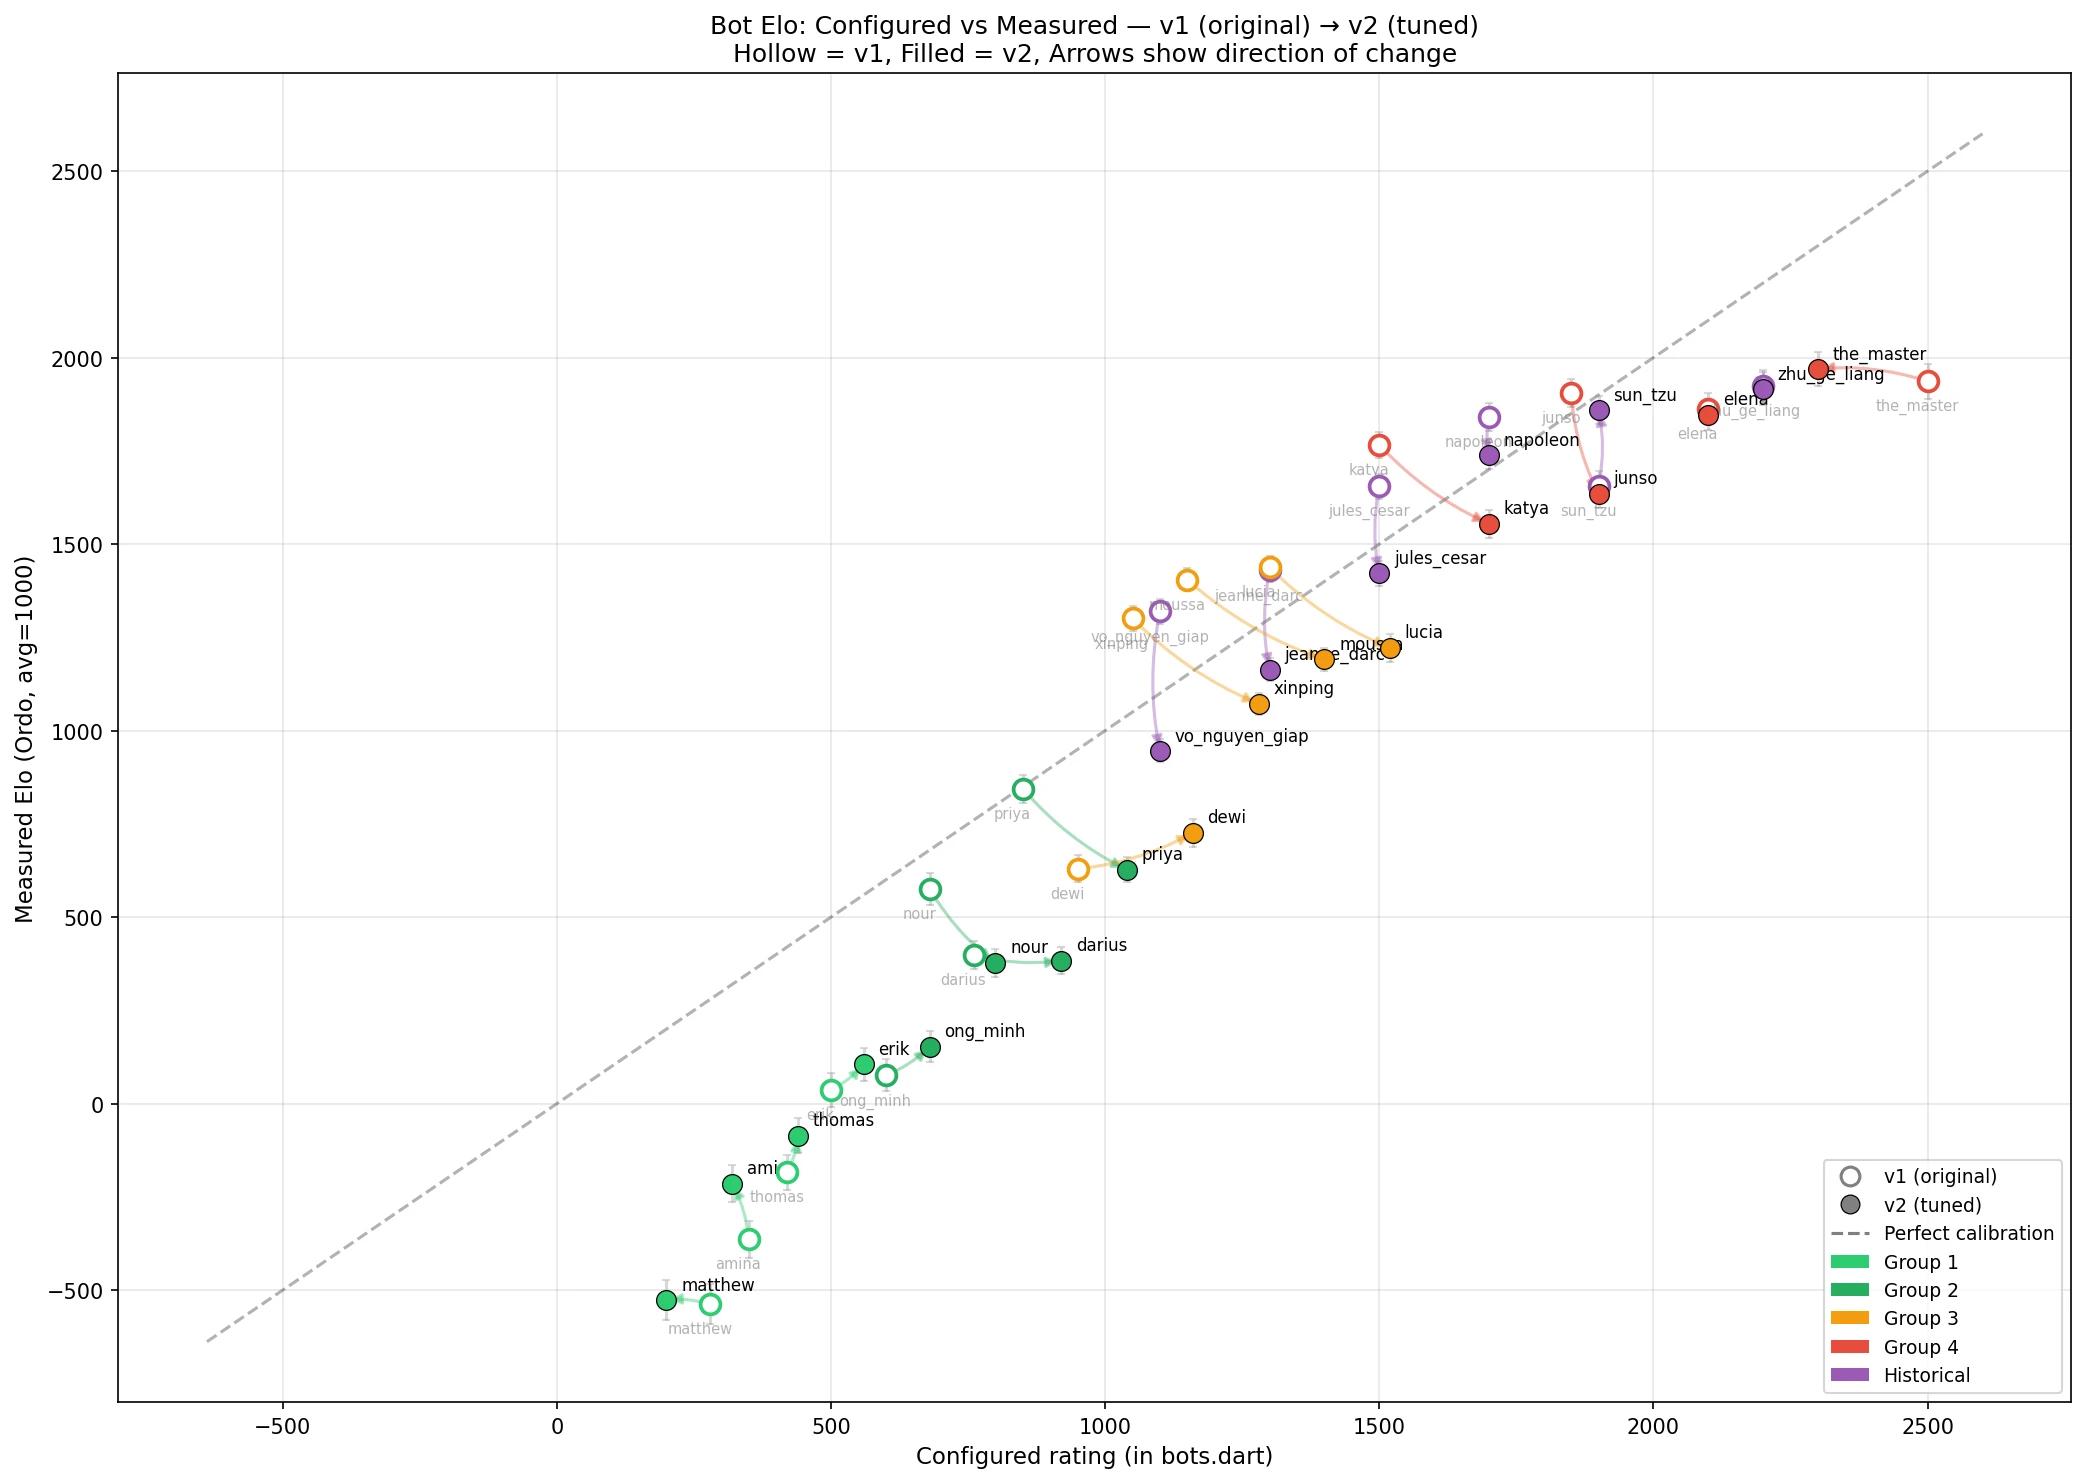
Um zu überprüfen, dass unsere Änderungen tatsächlich wirkten, veranstalteten wir ein spezielles Vergleichsturnier: Alle 22 Bots in ihrer ursprünglichen Konfiguration (v1) spielten gegen alle 22 Bots in ihrer optimierten Konfiguration (v2) auf derselben Elo-Skala. Das gab uns eine direkte, unmittelbar vergleichbare Messung, wie sich jeder Bot verändert hatte.

Die Pfeile zeigen Richtung und Ausmaß der Veränderung für jeden Bot. Blaue Pfeile nach rechts bedeuten, dass der Bot stärker wurde; rote Pfeile nach links bedeuten, dass wir ihn erfolgreich abgeschwächt haben. Die größten Abschwächungen betrafen Bots, die dramatisch über ihrem Niveau spielten: Vo Nguyen Giap fiel um 374 Elo-Punkte, Jun-so um 270 und Jules Cesar um 234. Auf der anderen Seite gewann Sun Tzu 202 Punkte hinzu, um seinen rechtmäßigen Platz unter den stärksten historischen Bots einzunehmen.
Die kombinierte Ansicht unten verbindet jeden Bot über beide Versionen hinweg und zeigt genau, wie sich die Kalibrierung verschoben hat.

Das abschließende Kalibrierungsdiagramm bestätigt, dass nach der Abstimmung die Bots korrekt geordnet sind, ohne Umkehrungen, und der Abstand zwischen den Schwierigkeitsstufen deutlich gleichmäßiger ist.

Was als Nächstes kommt: Aus Partien werden Puzzles
Die Zehntausende von Partien, die unser Turniersystem generiert hat, sind nicht nur für die Kalibrierung nützlich. Jede Partie ist eine Fundgrube taktischer und positioneller Muster. Unser nächster Schritt ist, diese Partien nach Puzzle-Material zu durchsuchen. Der Turnierrunner speichert bereits vollständige Stellung-für-Stellung-Engine-Bewertungen für jede Partie. Indem wir nach Stellungen suchen, in denen die Bewertung stark umschlägt — ein Spieler hatte einen Gewinnzug, aber der Gegner übersah ihn — können wir automatisch Puzzle-Kandidaten extrahieren. Dieser Ansatz liefert uns einen nahezu unbegrenzten Vorrat an frischen, bewerteten Puzzles aus Partien mit realistischen Stellungen, keine komponierten Endspielstudien. Bleiben Sie dran für unseren nächsten Artikel. Wer eher wissen will, wie man ein Niveau wählt und Bots zum Besserwerden nutzt, findet die praktische Seite in unserem Leitfaden zum Spiel gegen den Computer.