一切始於一封電子郵件
某天早上,我們收到一封來自一位一直在測試我們電腦對手的玩家的詳細郵件。他的發現令人大開眼界:被標示為棋社水準的電腦對手,實際上卻以候選大師的實力在下棋,遠超其難度等級所暗示的水準。一個位於「學徒」等級的對手不應該輕鬆擊潰有經驗的棋社棋手。在 Chess.com 等平台上,玩家把電腦對手當作個人進步的里程碑。如果我們的難度等級有誤,玩家就會誤判自己的水準,初學者也會被他們認為應該可以對抗的對手狠狠擊敗。我們決定從兩個方面著手解決:首先,重新校準每一個電腦對手,使難度遞進平順且排序正確;其次,從應用程式介面中完全移除 Elo 等級分。顯示像 1500 這樣的數字會引起與其他平台的直接比較,但象棋的等級分標準在不同網站之間差異極大。因此,我們改為將電腦對手組織成清晰的難度等級,讓玩家能專注於尋找合適的挑戰層級,無需擔心一個可能不代表他們所想意義的數字。今天你在象棋AI機器人頁面上看到的分級,就是這次重新校準之後的結果。
為什麼 Pikafish 讓校準變得困難
Xiangqi One 使用 Pikafish,這是最強的開源象棋引擎,作為每個電腦對手背後的大腦。Pikafish 極其強大,但這份力量是一把雙面刃。即使在非常低的搜尋設定下,Pikafish 的棋力也遠超初學者水準。它的強度隨搜尋深度呈指數增長,而非線性增長。從深度 1 到深度 3 並不是將棋力提升三倍,而是可能提升十倍。這意味著你不能簡單地將引擎深度對應到線性 Elo 等級分就了事。Xiangqi One 上的每個電腦對手不只是一個原始引擎,而是由多個參數構成的「個性」:搜尋深度、考慮多少候選走法(MultiPV)、電腦對手故意犯多少錯誤、失誤率的變異程度,以及電腦對手是選擇最佳候選還是更隨機地選擇。要為 22 個不同的電腦對手——從完全的初學者到接近特級大師水準——調對所有這些參數,正是校準挑戰的核心。
建構錦標賽基礎設施
為了衡量電腦對手的實際棋力,我們需要讓它們大規模地相互對弈,不是幾十場,而是數萬場。我們建構了一套錦標賽系統,能安排每一對相鄰電腦對手之間的對局、交替先後手使雙方均等地執紅和執黑,並將每場對局結果存入資料庫。每一輪錦標賽為每對電腦對手產生約 400 場對局,這為我們提供了具有統計意義的結果。所有對局結束後,我們將結果匯出為 PGN 檔案,並輸入 Ordo,這是一個 Bradley-Terry 等級分系統,能從對局結果計算 Elo 等級分。Ordo 是電腦棋類社群用來評測引擎的同一工具。它為每個電腦對手輸出帶有誤差範圍的等級分,讓我們精確了解真實的相對棋力。
初步結果:我們偏差了多少
首次錦標賽的結果敲響了警鐘。我們最初的電腦對手設定檔配置了從 280 到 2500 的等級分,結果嚴重失準。下方的圖表顯示了初始狀態:每個點代表一個電腦對手,X 軸是我們程式碼中配置的等級分,Y 軸是錦標賽測量出的 Elo。
重要說明:測量出的 Elo 是相對於電腦對手池的(Ordo 將平均值錨定在 1000),因此絕對數字不需要與配置的等級分一致。重要的是電腦對手的排序正確且間距均勻。

結果揭示了嚴重的問題。頂尖電腦對手(Elena、Jun-so、Katya)儘管配置的分數相差數百分,實際棋力卻幾乎相同。好幾個電腦對手的排序完全錯亂,理應較弱的反而贏了理應較強的。進度圖讓這些問題更加明顯。取代平順的階梯式難度遞增,出現了多處巨大的聚團——好幾個電腦對手的棋力幾乎相同,以及大段空白——難度突然跳躍。

一個玩家從 Erik(680)升到 Ông Minh(760)幾乎感覺不到差異,但從 Dewi 跳到 Xinping 則像撞上了一堵牆。這不是我們想要的體驗。
調校過程:四輪錦標賽迭代
修正校準需要多輪調整。每次錦標賽後,我們分析結果、找出最嚴重的偏差、微調引擎設定檔,然後再跑一次錦標賽。在第一輪中,我們調整了配置的等級分以更好地匹配測量棋力,並找出需要最大幅度修改設定檔的電腦對手。我們發現一個反覆出現的模式:防禦型風格的電腦對手始終超出其設定檔的預期棋力。一個防禦型對手的測量值會比配置相似的攻擊型對手高出數百 Elo。我們不得不大幅削弱幾個防禦型電腦對手,特別是 Nour 和 Vo Nguyen Giap。到了第四輪錦標賽,每個電腦對手都遵循了預期的層級排序,難度等級之間的間距也相當均勻。最大的個別變動包括:將 Sun Tzu 的棋力提升超過 200 Elo(給予他更深的搜尋和更精準的下法)、將 Jun-so 削弱 270 分(他對其等級來說過於強大)、以及徹底重新設計底部四個電腦對手,為新玩家創造更溫和的入門體驗。
調校前後:衡量改進成果
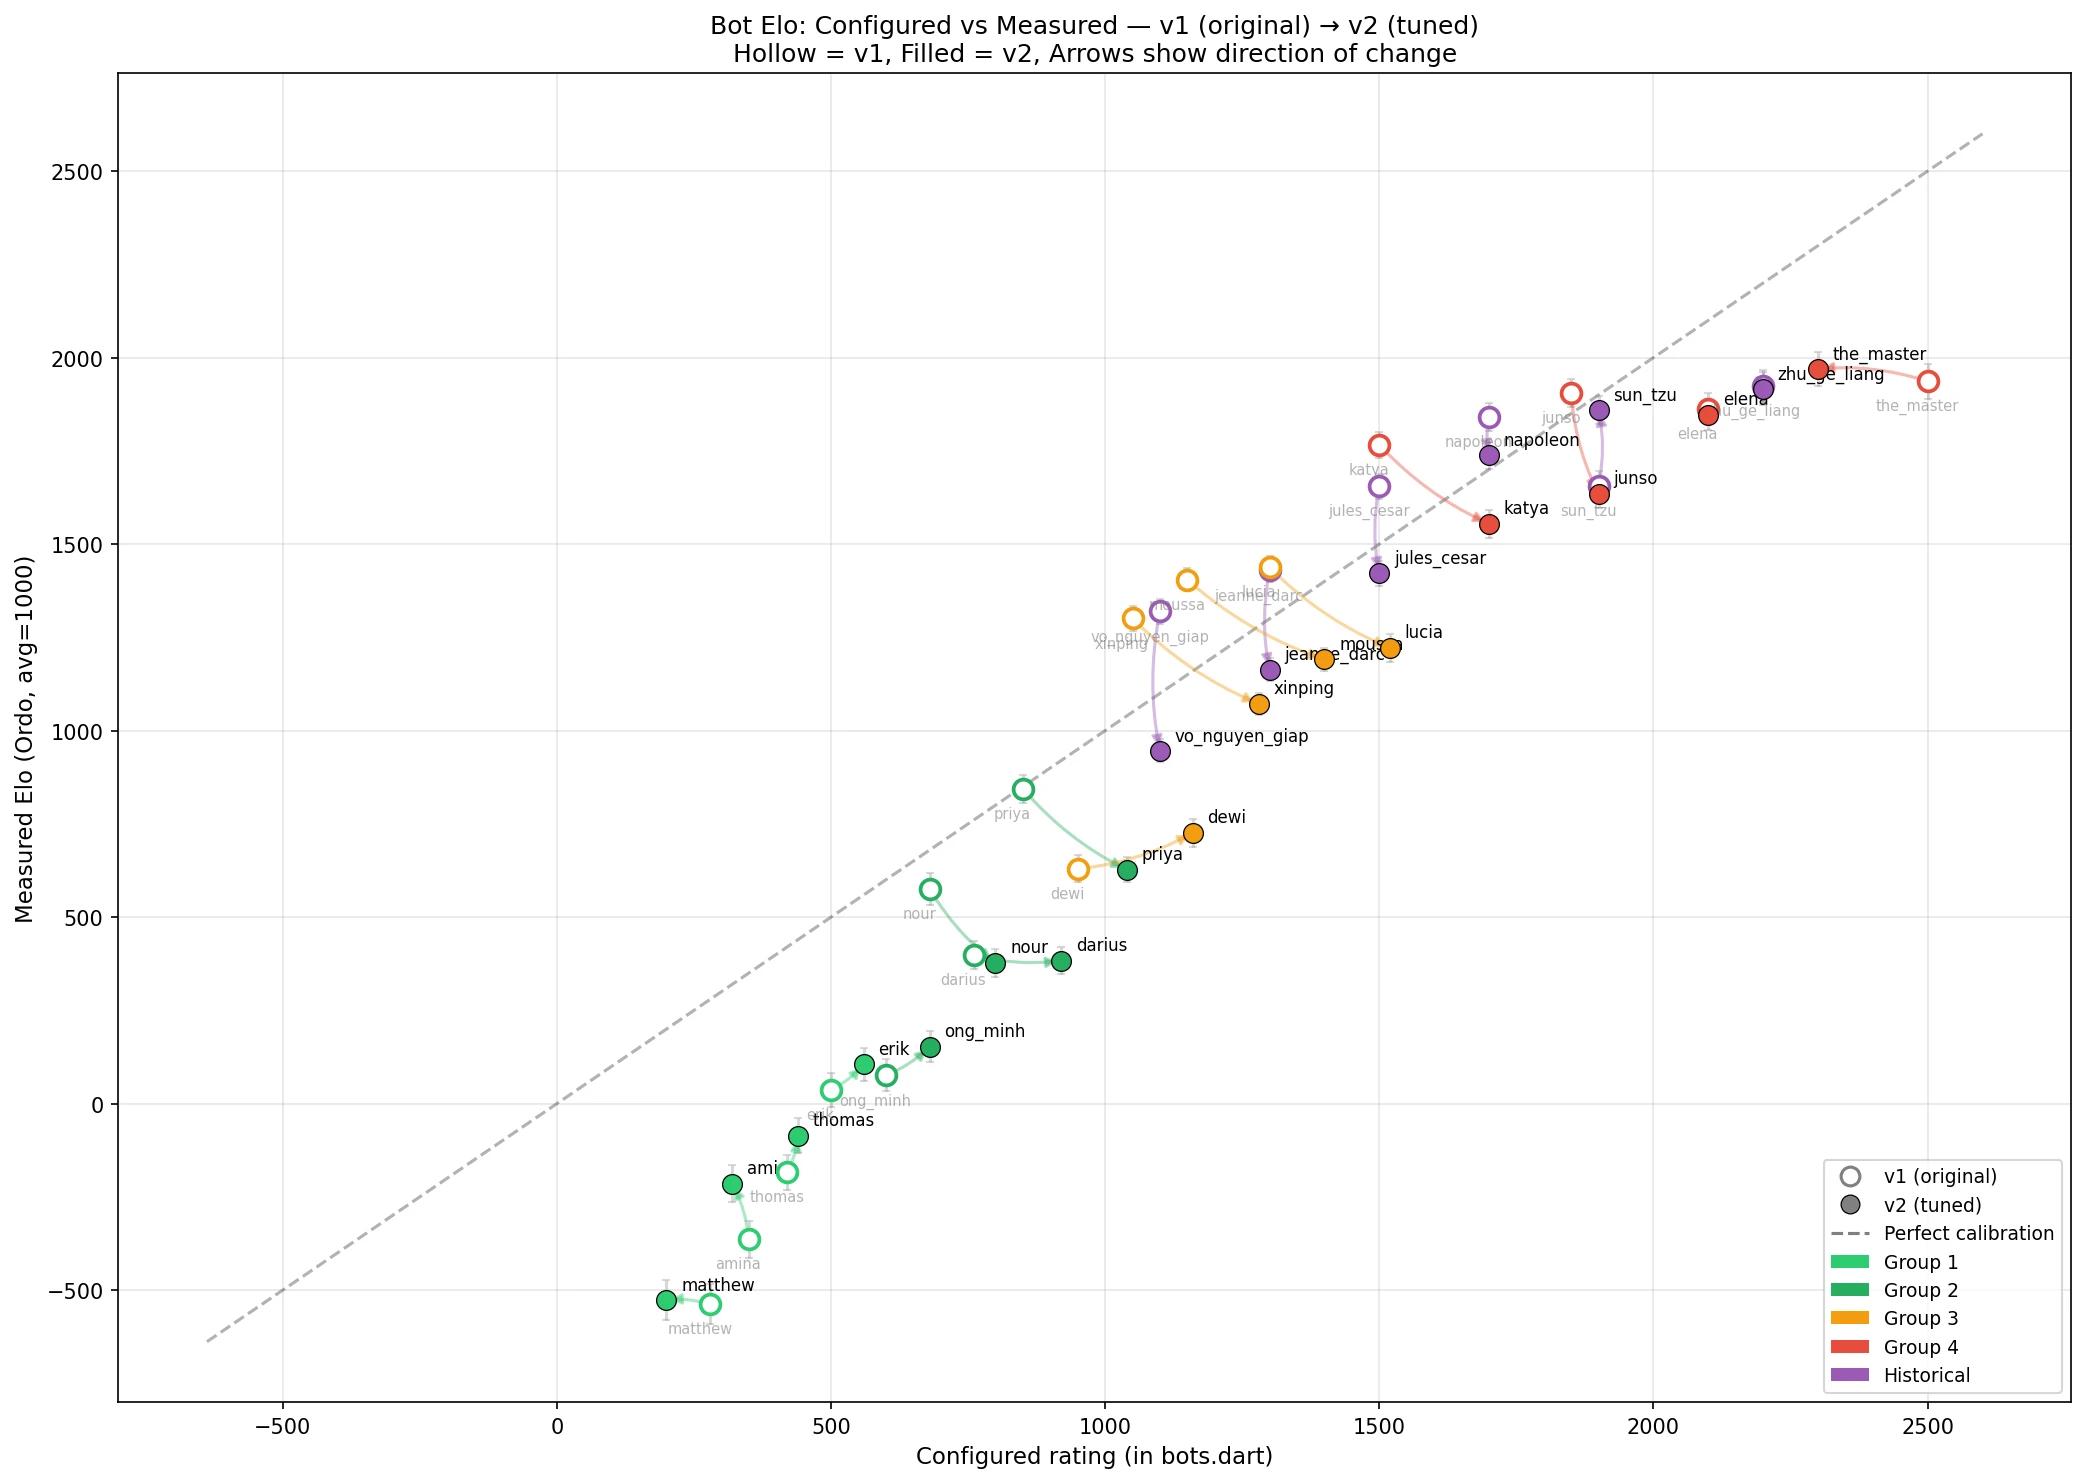
為了驗證我們的修改確實有效,我們進行了一場特別的對比錦標賽:所有 22 個原始配置(v1)的電腦對手與所有 22 個調校後配置(v2)的電腦對手在同一 Elo 量尺上對弈。這讓我們能直接、公平地衡量每個電腦對手的變化。

箭頭顯示每個電腦對手變化的方向與幅度。藍色箭頭向右表示該對手變強了;紅色箭頭向左表示我們成功削弱了它。最大幅度的削弱針對那些嚴重超出預期的對手:Vo Nguyen Giap 下降了 374 Elo、Jun-so 下降了 270、Jules Cesar 下降了 234。另一方面,Sun Tzu 提升了 202 分,在最強歷史人物對手中佔據了應有的位置。
下方的綜合視圖將每個電腦對手在兩個版本中連結起來,精確顯示校準如何移動。

最終校準圖確認,經過調校後,電腦對手排序正確、沒有逆序,難度等級之間的間距也更加均勻。

下一步:將對局轉化為謎題
錦標賽系統產生的數萬場對局不僅對校準有用。每一場對局都是戰術與局勢模式的寶庫。我們的下一步是從這些對局中挖掘謎題素材。錦標賽引擎已經為每場對局存儲了完整的逐步引擎評估。透過尋找評估值急劇變動的局面——一方有致勝走法但對手漏掉了——我們可以自動提取謎題候選。這種方法為我們提供了幾乎無限的、來自真實局面的全新分級謎題,而非人工創作的殘局習題。敬請期待我們的下一篇文章。如果你更想知道怎麼選難度、怎麼用機器對手提升棋力,我們的與電腦下象棋指南講的是實操那一面。